基于ANN人工神经网络的贷款决策风险评估——以Lending Club数据为例

摘要
本文针对P2P网贷市场中的信贷风险预测问题进行了深入研究。通过对Lending Club平台2007年至2020年总计2,925,493行数据、142个字段的贷款信息进行数据挖掘,综合借款人的基础历史信息与借款信息,提出基于贷款申请信息的属性划分方法,并结合客户细分形成信贷数据对象。
在数据预处理阶段,通过空值和重复行删除、离群异常值去除、单位和符号去除以及数据归一化处理来确保数据集质量。通过特征工程(特征衍生、特征抽象和特征缩放)进一步优化数据。使用Keras调谐器进行超参数调优,最终建立ANN网络模型对向量化特征进行分类,准确率达到**84.52%**,显著优于逻辑回归模型(56.81%)和XGBoost模型(64.94%)。
关键词:数据挖掘;贷款;风险评估;ANN人工神经网络
一、研究背景与现状
1.1 研究背景
在传统的贷款决策过程中,金融机构主要依赖借款人的征信、职业、收入等基础信息来评估其还款能力和意愿,然而这些信息往往无法全面反映借款人的真实风险状况。数据挖掘技术可以从多个维度获取借款人的信息,对借款人的历史交易、行为轨迹等数据进行深入分析,在风险出现前做出预警。
Lending Club成立于2007年,曾是美国最早、业务量最大、最为著名的P2P网贷机构。其官方发布的292万美国人的网络贷款数据集跨时13年,包含年龄、收入、职位、地理位置、贷款目的、信用评级等海量信息,是理想的机器学习建模数据集。
1.2 研究现状
目前的P2P网贷研究集中在运营模式、交易行为、借贷风险和社会网络四个方面。学者们对网络贷款风险研究多基于单向和消费者个人信息影响因素探究,均以欺诈和风险研究为导向,但现实中多方面因素的影响难以全面考虑。
在网贷信用风险评测模型建立层面,定性与定量相结合以及契合风险评估的多类型复杂系统建模方法被广泛应用到违约风险评估领域,多种机器学习方法被用于风险预测是目前的发展趋势。
本文的研究目标:
- 综合借款人的基础历史信息与借款信息,针对信贷数据繁杂且信息混杂的问题,进行数据理解与属性划分
- 结合文本类数据与时间序列数据进行风险建模,讨论贷款的风险类别
- 根据预测结果将信贷客户分为三类:全额结清、拖欠、超时
- 挖掘客户细分类间的重要风险特征,为信贷客户细分提供视角和方法参考
论文整体结构如下:
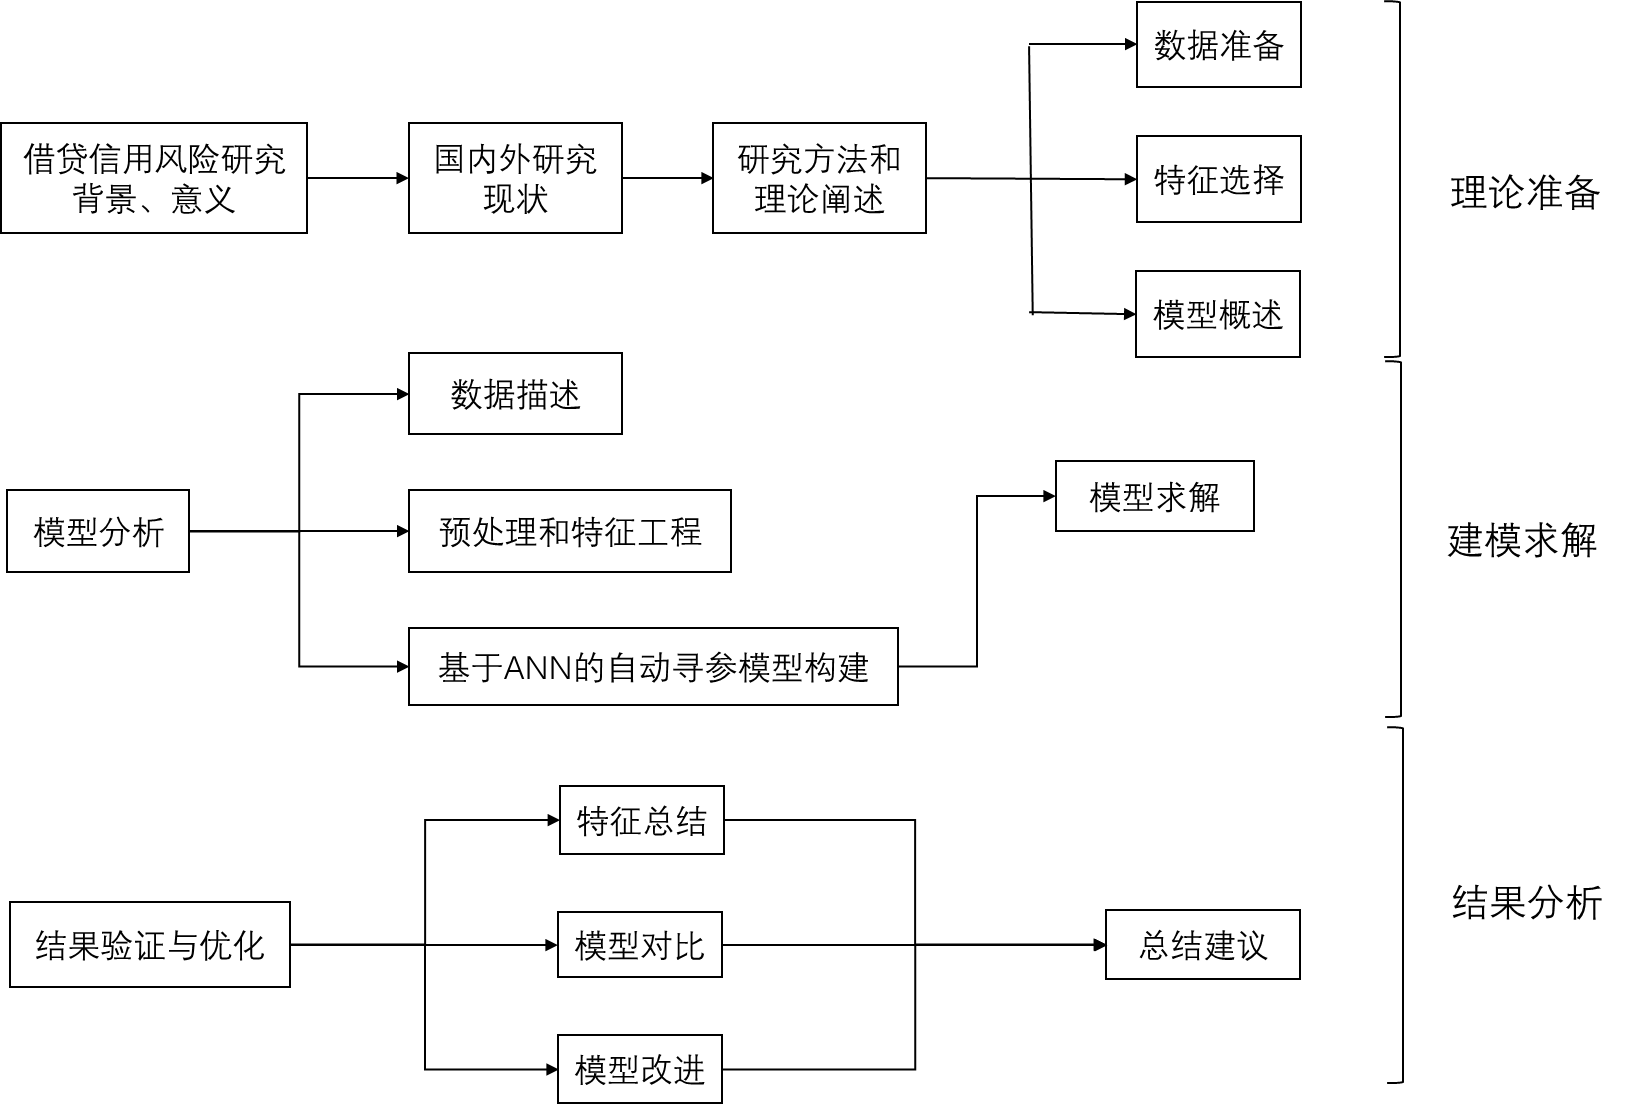
二、相关理论与方法
2.1 数据挖掘在贷款决策中的应用
在进行贷款决策评估时,数据挖掘技术可以帮助金融机构更准确地识别潜在的优质客户和不良客户。基于大样本的海量数据分析,使用大数据挖掘技术可以根据科学的算法发现隐藏在数据中的规律和模式,更准确地预测借款人的还款能力和意愿。这有助于金融机构制定更合理的贷款策略,提高贷款审批的准确性和效率。
在客户风险评估时,数据挖掘技术可以应用于信用风险评估和诈骗检测等方面。通过对客户的信用历史、财务状况和交易记录等数据的深入分析,数据挖掘技术可以帮助金融机构更准确地评估客户的信用风险,降低坏账率。
2.2 ANN人工神经网络
本文采用人工神经网络(ANN)算法,通过模拟大脑生物神经网络的突触节点,实现对数据之间复杂关系的建模。
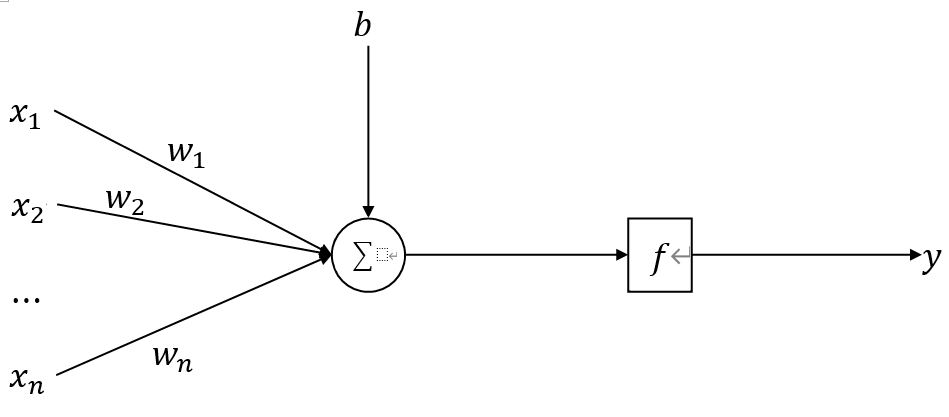
神经元结构
神经元也称”激活单元”,一般具有多个输入值及其权重、一个恒为1的截距项(偏置单元)和一个输出值 y:
其中
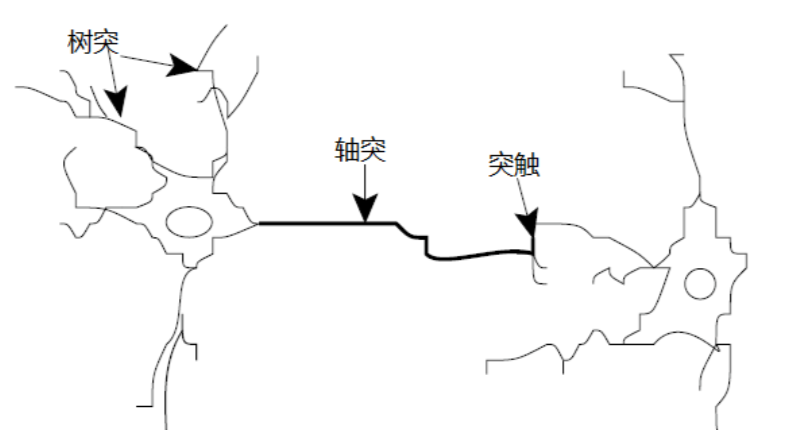
ANN的基本结构包括输入层、隐藏层和输出层。输入层接收原始数据,隐藏层对数据进行加工处理,输出层则产生最终的预测或分类结果。
2.3 Softmax激活函数
Softmax激活函数通常用于多分类问题的输出层,可以将一个数值向量归一化为一个概率分布向量,各个概率之和为1。
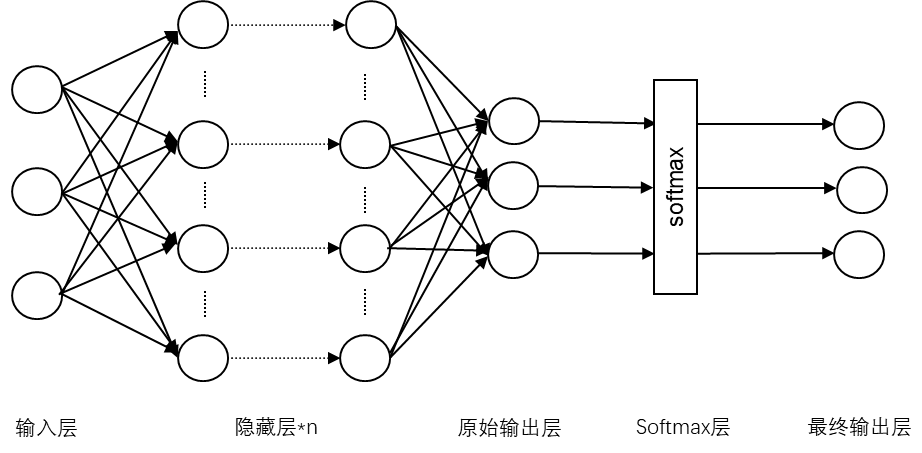
对于第i个节点输出,Softmax函数为:
其中
2.4 交叉熵损失函数
交叉熵损失函数主要用于评估分类问题中模型的预测概率分布与真实概率分布之间的差异程度:
其中M为类别的数量,
2.5 随机森林
随机森林是一种拓展的并行式集成学习方法,在训练基学习器时采用有放回采样的方式添加样本扰动,同时引入属性扰动:在选择划分属性时,先从候选属性集中随机挑选出一个包含K个属性的子集,再从中选择最优划分属性。
三、数据收集与预处理
3.1 数据来源
数据集来源于Lending Club官方网站,包含了从2007年到2020年实际发放的贷款信息,总计2,925,493行数据,142个字段。这些字段包括:
- 借款人基本信息:年龄、性别、工作、工资收入等
- 借款详情:借款金额、借款期限、借款利率、借款用途等
- 借款的还款状态
3.2 数据预处理
自变量处理:常识性剔除贷款申请和发放无关特征,并剔除部分贷款发放后特征,最终得到18个样本观测值。对部分连续变量进行空值和离群值的去除处理。
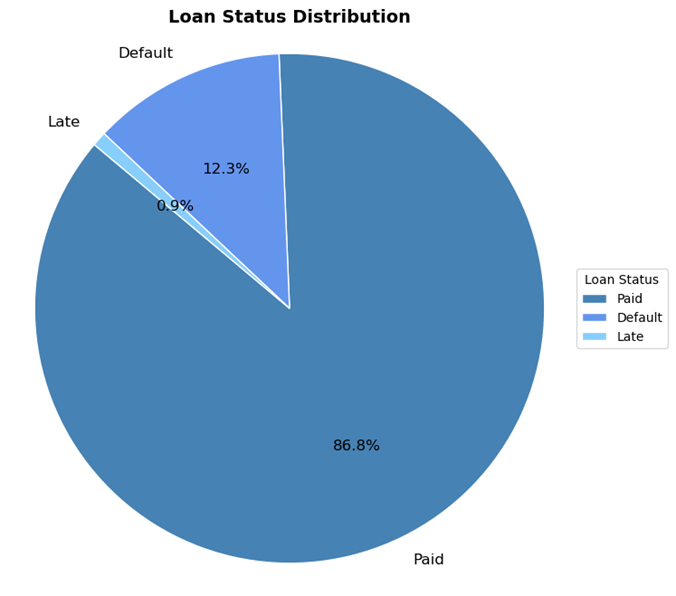
因变量处理:将目标变量 loan_status 重新映射归类:
- Paid(全额结清):占比 86.8%
- Default(欠款):占比 12.3%
- Late(超时/延期):占比 0.9%
3.3 描述性统计
从描述性统计来看:
- 贷款金额标准差9,458.46,表明贷款金额有较大个体差异
- 贷款期限中位数为36个月,标准差11.04个月
- 利率中位数12.49%,标准差4.86%,分布较为集中
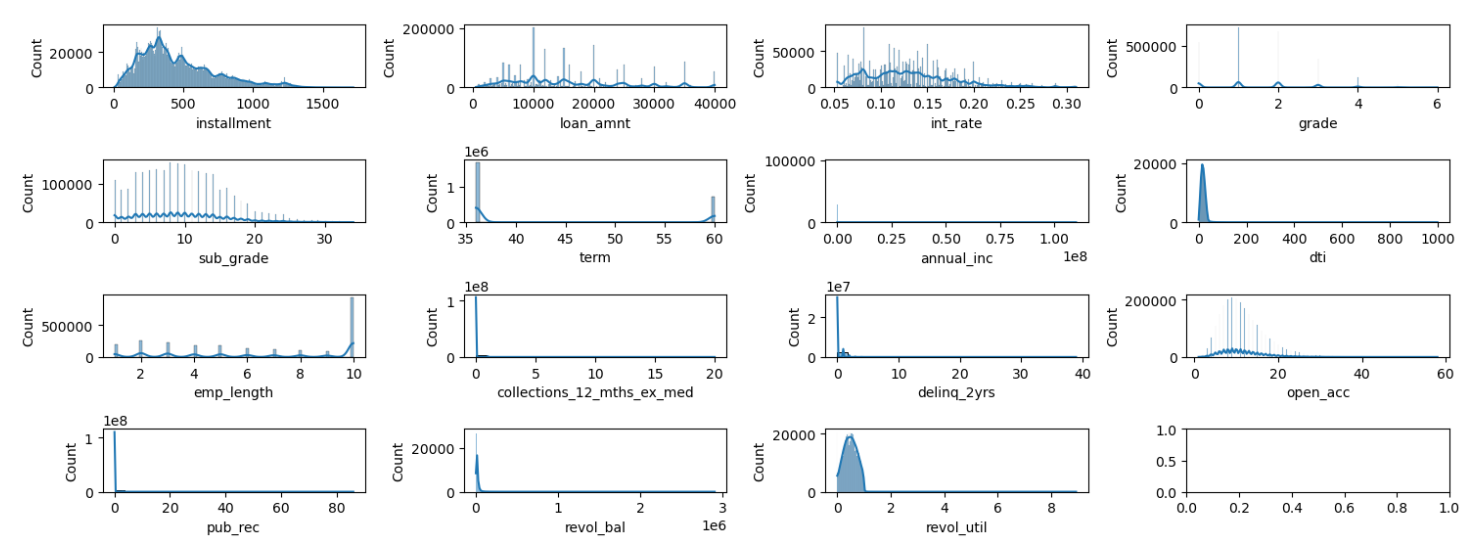
从直方图可以看出,大部份客户月付金额在0-500之间,贷款金额峰值在10,000左右,且与贷款利率有相似的分布,债务收入比非常低(均在50%以内)。值得注意的是贷款期限出现了极值明显的情况,大部分客户均为36月与60月的贷款期限。
3.4 多重共线性检验(VIF)
VIF值可以表征自变量之间的共线性程度:
如果VIF值较高(通常>10),表明该自变量与其他自变量高度相关,存在多重共线性问题。根据计算,部分变量存在严重的多重共线性,后续将通过主成分降维处理。
3.5 交叉验证与不均衡数据处理
数据集的类别非常不均衡,需要进行交叉验证减少模型评估的方差。
针对数据不均衡问题,分别使用了欠采样和过采样进行比较:
| 采样方法 | Paid准确率 | Default准确率 | Late准确率 | 综合准确率 |
|---|---|---|---|---|
| 欠采样 | 高 | 中 | 低 | 13% |
| 过采样 | 低 | 0.88 | 低 | 88% |
实验结果表明,随机过采样综合表现优于欠采样,过采样在Default类别上表现最好(精确率0.9、召回率0.97、F1分数0.93均>0.9),因此选择随机过采样后的数据进行进一步分析。
四、变量选取与特征工程
4.1 变量选取
从借款人的各项数据中选择出对贷款决策和风险评估有影响的特征,分为两个方面:
贷款信息因素:月还款额、债务水平、贷款金额、贷款利率、贷款等级等
客户信息因素:
- 硬性指标:年收入、债务收入比、住房情况
- 个人因素:工作年限、贷款用途
- 信用指标:逾期次数、开放信用账户数量、公开贬损记录、循环信用余额、收入验证、循环信用利用率
4.2 特征衍生——PCA数据降维
针对共线性非常显著的贷款信息类别数据,采用主成分分析(PCA)进行降维处理。
第k个主成分的贡献率:
因子载荷量:
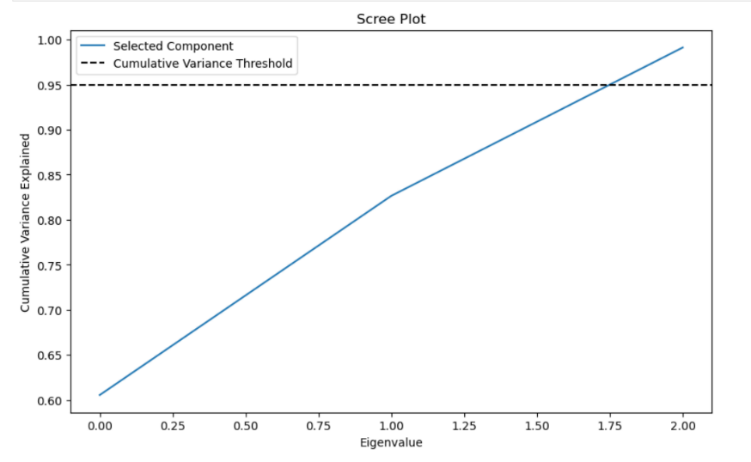
从碎石图可知,选择3个主成分可以解释超95%的方差,降维后的三个主成分分别解释了60.56%、22.10%、16.50%的方差,共计**99.16%**的方差被捕获。
4.3 特征抽象
独热编码:对房屋所有权、身份认证、贷款目的等文本列进行独热编码处理,转化为二进制变量。
数值映射:Lending Club将贷款等级分为A-G共7个等级,每个等级含1-5五个子级。将官方评定的等级按规则进行赋分处理,将抽象的等级数据量化为连续的数值变量。
4.4 特征缩放——归一化
将数据集进行量级归一化处理,消除不同特征之间巨大数值差异对模型训练的影响:
五、模型建立与评估
5.1 预测模型构建
使用Keras调谐器进行超参数调优,关键参数设置如下:
| 参数 | 搜索范围 |
|---|---|
| 隐藏层数量 | 4 ~ 20 |
| 每层神经元数 | 32 ~ 512(步长32) |
| 学习率 | 0.01, 0.001, 0.0001 |
| 激活函数 | ReLU |
| 输出层激活 | Softmax |
| 损失函数 | 多类交叉熵 |
根据调优结果,最佳模型配置为:全连接层数量为3层,分别有288、320、64个神经元。
5.2 模型性能评估
模型的整体准确率达到 **84.52%**,详细指标如下:
| 指标 | 数值 |
|---|---|
| 准确率(Accuracy) | 84.52% |
| 精确率(Precision) | 81.04% |
| 召回率(Recall) | 84.52% |
| F1值 | 82.40% |
模型的准确率和召回率较高,精确率略有欠缺,可能是因为模型对某些类别边界不够敏感。
5.3 模型对比分析
| 模型 | 准确率 |
|---|---|
| ANN | 84.52% |
| XGBoost | 64.94% |
| 逻辑回归(LR) | 56.81% |
ANN模型的整体性能最优越,在该数据集上显著优于XGBoost和逻辑回归模型。
5.4 模型优势
- 调优灵活性:通过Keras调谐器有效搜索最佳模型参数
- 概率输出预测:输出层采用Softmax激活函数,将输出转换为概率分布
- 损失函数处理:使用多类交叉熵损失函数,有效衡量预测误差
- 多性能指标评估:综合使用准确率、精确率、召回率、F1值全面评估模型
六、特征结果分析与业务建议
6.1 关键特征识别
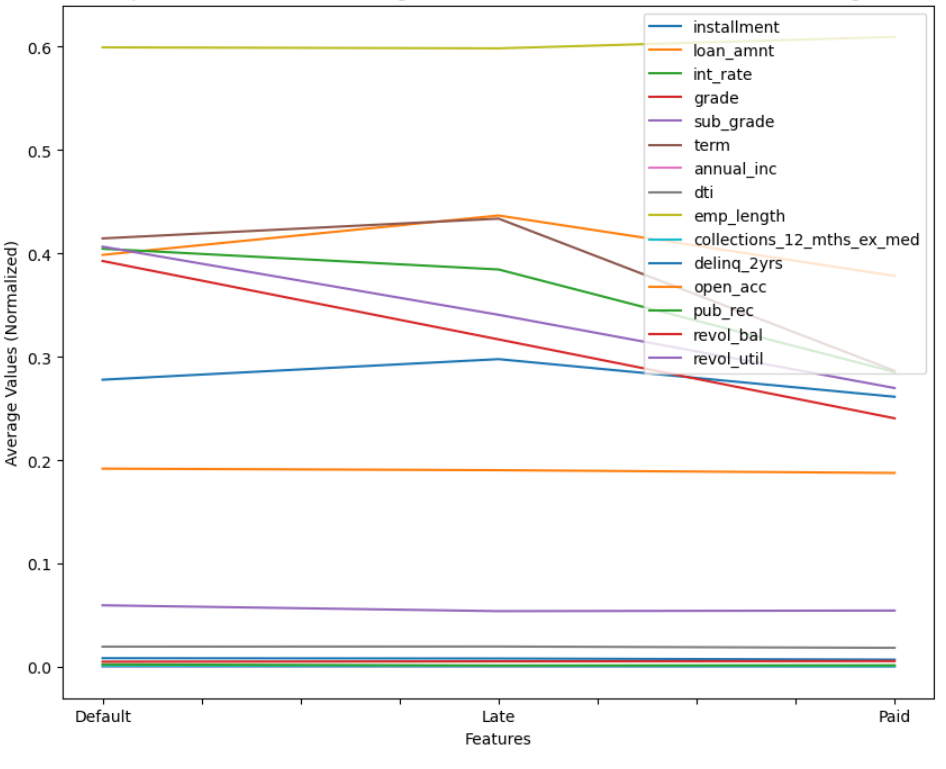
从特征分析来看,区分不同类别贷款客户的主要特征为:
- term(贷款期限)
- open_acc(开放信用账户数量)
- int_rate(贷款利率)
- sub_grade(贷款子等级)
- revol_bal(循环信用余额)
- installment(月付贷款)
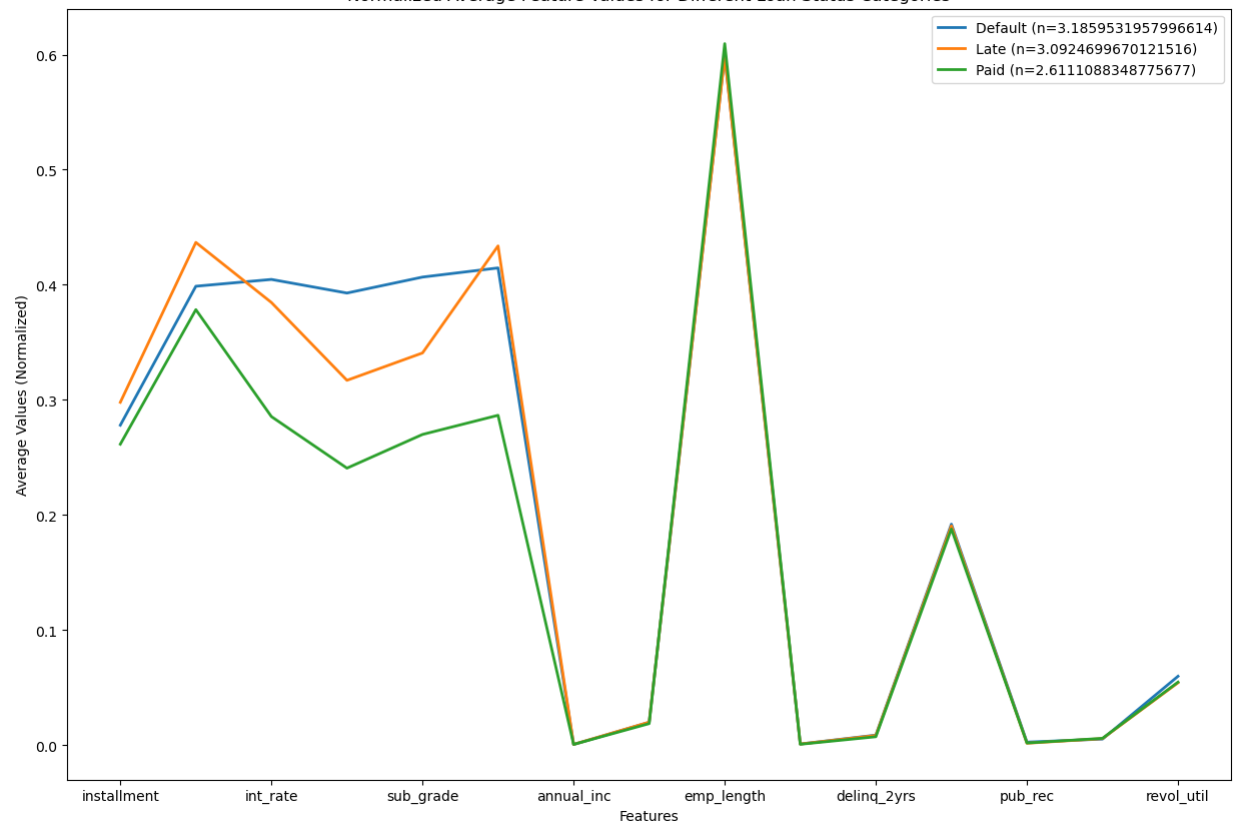
6.2 客户画像与建议
Paid类型(已全部归还贷款)
特征:贷款利率、贷款子等级、月付贷款均值显著低于其他类别。这类客户通常有良好的信用记录和还款能力。
建议:
- 减少贷款门槛,降低贷款手续信息的繁琐程度
- 增加此类贷款的投放规模,实现”薄利多销”
- 提供更多优惠政策(如减免手续费、降低利率等)
Late类型(延期归还贷款)
特征:平台评级较低,月付贷款和利率较高,还款压力大。
建议:
- 进行定期或实时分析与监测
- 安排专人进行还款规划提醒
- 根据客户实际情况调整还款期限与月付贷款
- 加强贷后管理
Default类型(欠款)
特征:特征相对均衡,利率保持最高水平,存在一定风险。
建议:
- 加强风险评估与特征权重分配
- 增加个人身份或其他平台身份绑定
- 联合其他企业对不守信用违约账户进行冻结或限制
- 制定有效的催收策略
- 将可能的坏账损失纳入考虑范围
七、研究结论与展望
7.1 研究结论
本文基于Lending Club 2007-2020年的292万条贷款数据,通过完整的数据挖掘流程,建立了ANN神经网络风险评估模型:
- 数据预处理:删除空值和重复行、去除离群异常值、正则化去除单位和符号、数据归一化处理
- 特征工程:PCA降维(6个高共线性特征→3个主成分,解释99.16%方差)、独热编码、数值映射、归一化
- 不平衡处理:过采样准确率88%远优于欠采样13%
- 模型效果:ANN准确率84.52%,显著优于XGBoost(64.94%)和逻辑回归(56.81%)
7.2 研究局限性
- 数据指标局限:样本人群为美国公民,模型预测结果可能与东亚地区有差异
- 社会环境变化:2007-2020年间存在通货膨胀、利率调整、政策环境变化等因素,以及新冠疫情带来的行为变化
- 不平衡样本处理:仅选取了随机过采样和基于距离的过采样对比,还有更多方法可尝试
7.3 未来方向
- 探索Stacking、Bagging、Boosting等集成学习方法
- 自动化的特征选择和特征构造
- 结合图像、声音、IP地址等多模态数据进行建模
- 引入第三方消费平台数据(购物品牌及金额等)
- 研究可解释性模型和特征主导的客户分类、风险量化评级
主要参考文献
- 陈健巧. 普惠金融背景下P2P投资者的借贷行为影响因素研究[D]. 上海交通大学, 2022.
- 蔡青松, 吴金迪, 白宸宇. 基于可解释集成学习的信贷违约预测[J]. 计算机系统应用, 2021, 30(12): 194-201.
- 刘翱, 邓旭东, 童泽平等. P2P网络借贷研究进展[J]. 系统工程学报, 2020, 35(03): 402-415.
- 刘帅祺. 商业银行互联网贷款信用风险评估及客户特征发现[D]. 北京科技大学, 2023.
- 吴利娟, 孟泽远. 基于BP神经网络的银行机构绿色信贷风险评价研究[J]. 时代经贸, 2023, 20(11): 72-76.
- Artem Bequé, Stefan Lessmann. Extreme learning machines for credit scoring: An empirical evaluation[J]. Expert Systems With Applications, 2017, 86: 24-27.
- Wijaya C., Nugroho B. Y., & Arkanuddin M. F. The Important Role of Financial Architecture Regulation Toward Fintech P2P Lending Ecosystem[J]. Indonesian Journal of Business and Entrepreneurship, 2024, 10(1), 13.
- 标题: 基于ANN人工神经网络的贷款决策风险评估——以Lending Club数据为例
- 作者:
- 创建于 : 2024-04-28 00:00:00
- 更新于 : 2026-08-06 13:51:16
- 链接: https://github.com/MinjieY/post/2fdb6b50这两个插件会让md打开变慢吗.html
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。